FinOps et expertise technique sur le cloud public : comment réduire d’1/3 les coûts d’environnements hors production par un mécanisme intelligent d’arrêt relance ?
FinOps sans Expertise technique n’est que du vent
Les organisations ont migré sur le cloud public, tout s’est bien passé, pour cette même raison, elles ont élargi le périmètre en migrant de nouvelles applications et activant au passage quelques services cloud complémentaires, mais la facture mensuelle, elle, n’arrive pas à tenir dans le budget pourtant révisé à la hausse. Le FinOps devient alors un sujet.
On entend parler de FinOps à toutes les sauces, tous les cabinets de conseil se sont dotés d’une “practice” FinOps avec de jeunes consultants tirés à 4 épingles bardés de présentations Powerpoint brillantes et de tableaux Excel impeccables.
Sauf que n’importe quel débutant est capable d’extraire les données de coûts détaillés de votre facture de cloud public, voire d’en tirer quelques tableaux croisés dynamiques, et au final pointer ce que vous savez déjà : les quelques postes douloureux qui constituent le cœur de votre facture.
À partir de là, tout reste à faire. Bien sûr qu’il est indispensable d’y voir clair dans ses chiffres, mais le vrai FinOps est bien dans la recherche des leviers et solutions techniques que l’on va pouvoir mettre en œuvre pour réduire ces postes subis.
Le cas concret que nous présentons dans cet article illustre cette démarche et le savoir-faire d’une équipe cloud créative. Comment remettre en cause les pratiques établies et jugées incontournables pour imaginer une autre façon de raisonner.
FinOps sans Expertise technique n’est que du vent
Les organisations ont migré sur le cloud public, tout s’est bien passé, pour cette même raison, elles ont élargi le périmètre en migrant de nouvelles applications et activant au passage quelques services cloud complémentaires, mais la facture mensuelle, elle, n’arrive pas à tenir dans le budget pourtant révisé à la hausse. Le FinOps devient alors un sujet.
On entend parler de FinOps à toutes les sauces, tous les cabinets de conseil se sont dotés d’une “practice” FinOps avec de jeunes consultants tirés à 4 épingles bardés de présentations Powerpoint brillantes et de tableaux Excel impeccables.
Sauf que n’importe quel débutant est capable d’extraire les données de coûts détaillés de votre facture de cloud public, voire d’en tirer quelques tableaux croisés dynamiques, et au final pointer ce que vous savez déjà : les quelques postes douloureux qui constituent le cœur de votre facture.
À partir de là, tout reste à faire. Bien sûr qu’il est indispensable d’y voir clair dans ses chiffres, mais le vrai FinOps est bien dans la recherche des leviers et solutions techniques que l’on va pouvoir mettre en œuvre pour réduire ces postes subis.
Le cas concret que nous présentons dans cet article illustre cette démarche et le savoir-faire d’une équipe cloud créative. Comment remettre en cause les pratiques établies et jugées incontournables pour imaginer une autre façon de raisonner.
Le contexte client : une plateforme digitale très évolutive avec un nombre croissant d’environnements de développement
Notre client opère plusieurs sites e-Commerce B2B sous différentes technologies, tous hébergés sur Azure et infogérés par Alfa-Safety.
Il a engagé sur plusieurs années une roadmap ambitieuse, avec un rythme très soutenu de développement et d’évolution de ses applications digitales.
Pour mener ces projets de développements en parallèle, nous avons été amenés à multiplier des séries d’environnements de développement, qualification, recette, chaque projet ayant son planning et ses contraintes techniques propres, auxquels s’ajoute une pré-production assez coûteuse car parfaitement iso-prod.
Le point de départ de la réflexion est venu de l’analyse FinOps. La multiplication des environnements de développement nécessaires à la roadmap pesait lourdement sur la facture cloud mensuelle. Même si ces environnements n’étaient pas unitairement toujours très coûteux, leur nombre finissait par chiffrer. Pas question par ailleurs de freiner les développements en restreignant les moyens disponibles.
Un axe d’économie : éteindre les environnements au maximum pendant les plages de non-utilisation
La piste d’arrêt relance des environnements avait été initialement écartée…
Le coût des ressources avait déjà fait l’objet d’une optimisation au travers de réservations tarifaires, de choix de services moins coûteux, d’ajustement de sizing, il ne restait plus beaucoup de marge de manœuvre de ce point de vue-là.
L’équipe est donc revenue à un axe d’économie qui avait été écarté au début : éteindre au maximum les environnements en dehors des heures ouvrées, la nuit et le week-end quand ils ne sont pas utilisés.
Cette option avait été écartée initialement car jugée trop contraignante, risquée techniquement, et trop partielle :
- Contraignante pour les développeurs et équipes de recette qui ne souhaitaient pas être bloqués par un mécanisme trop rigide. En cas de correction urgente ou dans la bousculade des derniers jours avant une livraison, ils voulaient pouvoir disposer des environnements hors prod sans être liés par un délai de prévenance, voire pouvoir laisser tourner des tests la nuit sur certaines parties de l’infrastructure,
- Risquée techniquement car le redémarrage de certaines applications se révélait parfois délicat et incertain, et la crainte était forte de prendre tous les gains potentiels en temps passé à gérer les incidents et en indisponibilité pour les équipes de dev. en cas d’échec des redémarrages,
- Enfin, beaucoup d’exclusions, justifiées ou non, venaient limiter le champ d’application et donc les gains potentiels,
Il avait donc été estimé que l’effort à mener était trop élevé par rapport à un gain modéré et incertain et un niveau de contrainte excessif.
Dans le contexte des débuts sur le cloud, l’option de l’arrêt relance des environnements avait été jugée trop complexe et non prioritaire et on en était resté là..
…pour être finalement relancée sous la contrainte FinOps
Toutefois le sujet a été relancé sur la base d’une équation simple:
- En jouant sur les tarifs, il est possible atteindre 35 à 40% maximum d’économies sur le tarif cloud à la demande, avec des contraintes fortes de réservation
- Inversement, en éteignant les environnements de 20h à 8h le lendemain matin ainsi que le week-end, il serait possible d’économiser (12hx5) + (24hx2) = 108h/(24×7) = 65% du temps, au tarif à la demande.
- Soit dans une hypothèse prudente, on pouvait passer :
- sur la base d’un coût nominal de 100 en 24/7 et tarif à la demande
- de 60 en 24/7 avec une tarification optimisée au maximum via des réservations
- à 35 en 12/5 en tarif à la demande , sans effort d’optimisation tarifaire,
- soit un gain supplémentaire de 40% sur l’ensemble des environnements hors production.
Il a donc été décidé de ré-explorer cette option en proposant des solutions aux craintes des équipes de développement.
Un cahier des charges exigeant construit conjointement par l’ensemble des équipes
Pressées par la contrainte budgétaire et le besoin de pouvoir financer des ressources supplémentaires par ailleurs, les équipes développement, Devops et Infrastructures ont donc dressé un cahier des charges permettant de surmonter les écueils qui avaient conduit au départ à écarter cette option:
- un déclenchement des arrêts relance pilotable par les équipes de développement…
- mais dont le parfait fonctionnement est garanti par les équipes Devops et Infra, en particulier le redémarrage des applications le matin sans anicroche,.un mécanisme simple, éteignant un maximum de ressources facilement identifiables, une maintenance minimale,
Beaucoup de soins apportés aux détails dans la réalisation
Une planification pilotée par les développeurs
Les environnements sont prévus par défaut pour être éteints:
- en semaine de 21h à 6h
- en week-end, toute la journée,
- les environnements sont rallumés assez à l’avance pour permettre des traitements quotidiens.
Le mécanisme d’arrêt-relance lui-même est déclenché depuis un ordonnanceur piloté par l’équipe de développement avec la possibilité pour les développeurs de modifier eux-mêmes les horaires, c’était une condition importante.
Par exemple, si pour une campagne de tests, on veut garder tel environnement disponible tout le week-end, c’est possible et très simple.
Un Arrêt-Relance à la carte mais exhaustif
On éteint les ressources par application et par environnement:
- environnement de pré-production
- environnement de développement, chacun de ces environnements de développement contenant eux-mêmes plusieurs sous environnements, Dev, qualif, recette…
La sélection se fait via les “resource groups”, avec toutefois la possibilité d’exclure des ressources spécifiques; cela pourrait aussi être réalisé via du tagging.
Donc tout nouveau composant intégré dans un Resource Group est automatiquement pris en compte dans le mécanisme d’A/R, ou inversement.
Les ressources les plus coûteuses sont bien prises en compte: VMs et les NodePools dans Kubernetes, bases de données, les différents caches, moteur d’indexation/recherche, gestionnaire de messages
L’orchestration de l’Arrêt-Relance est critique, et largement facilitée par Kubernetes
L’ordre des opérations est très important pour garantir le bon fonctionnement applicatif:
- 1/applications
- 2/VMs ou NodePool
- 3/middlewares ,
- en sens inverse au redémarrage.
Cela fonctionne bien pour les composants sur VMs, mais est grandement facilité pour les applications déployées sous Docker/Kubernetes : ce dernier assure le redémarrage des applications dès que les nœuds remontent dans le K8S.
Tout cela n’est possible qu’avec une CI/CD parfaitement rodée, les bonnes configurations Helm, et une connaissance approfondie des applications.
Un point d’attention a été porté sur les flux qui sont synchronisés avec les horaires d’A/R.
Une fois ces trois objectifs atteints, il ne restait plus qu’à laisser les développeurs programmer les Arrêts-Relance.
Un bilan au-delà des attentes : fonctionnement efficace et 20% de gain FinOps sur la facture globale
Avec maintenant quelques mois de recul, le mécanisme est fiable, fonctionne bien, aucune erreur n’a été relevée au redémarrage,
La possibilité de laisser les déclenchements à la main des développeurs a contribué à faire accepter la solution, la personnalisation des arrêts est utilisée peu fréquemment mais régulièrement et appréciée.
Les plages horaires d’extinction ont été un peu réduites par prudence, les environnements sont rallumés à 6h au lieu de 8h envisagés.
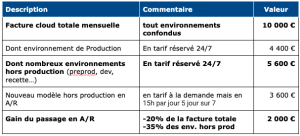
Le tableau suivant illustre le gain obtenu sur la facture globale sur une base de 10.000 € HT, qui dans le cas de notre client se chiffrait en dizaines de milliers d’euros mensuels HT; on vous laisse extrapoler.
Le ROI de l’opération est inférieur à deux mois : La charge de travail pour concevoir, réaliser, tester et mettre en œuvre la solution est réelle, mais aucune difficulté majeure n’a été rencontrée.
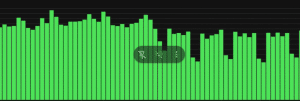
Le graphique ci-dessous illustre la propagation des gains les environnements hors production et sur les toutes premières semaines , sachant que le déploiement se fait progressivement par environnement et s’est poursuivi par la suite.
Des gains complémentaires plus diffus mais réels ont également été relevés:
- Au passage cela soulage de la contrainte des réservations tarifaires
- Un gain indirect a été relevé sur tous les services connexes facturés à la volumétrie : Logs, Supervision, flux réseaux, sécurité (antivirus, analyse de traces) , les compteurs ne tournent plus pendant que les environnements sont arrêtés.
Les facteurs clés de succès
- Une approche full DevOps et la bonne collaboration entre les différents intervenants : Développement, DevOps et Infra. On voit bien que la solution a impliqué ces trois équipes, du cadrage à la conception en terminant par la validation.
- Une chaîne de déploiement CI/CD fiable et bien automatisée
- Kubernetes est incontestablement une plateforme parfaitement adaptée ,
- Une expertise cloud de haut niveau capable d’imaginer les solutions techniques et de les mettre en œuvre rapidement.
- la combinaison d’une analyse Devops avec l’expertise technique, pour proposer des solutions techniques permettant de matérialiser des gains.
- Une analyse de ROI objective et un cadrage rassurant des objectifs qui permet de mobiliser le temps et les ressources nécessaires à un chantier auquel personne ne voulait consacrer du temps, perçu comme éloigné des “contraintes du terrain”.
Vous opérez une plateforme cloud devenue conséquente sur Azure, AWS ou GCP ?, vous avez déjà bien engagé des optimisations tarifaires de coûts et fait la chasse au sizing excessif ? vous cherchez à aller plus loin et vous souhaitez reprendre la maîtrise de votre infrastructure cloud et de sa facture ?
Pour faire un 1er diagnostic de votre plateforme, sa structure de cloud et son architecture et ses méthodes de déploiement et les axes de gains potentiels, contactez-nous.